티스토리 뷰
업무 문서를 AI로 정리하면 빠르다. 하지만 빠르게 요약하려고 회사 문서와 메일을 그대로 넣는 순간 다른 문제가 생긴다. 문서에는 고객명, 담당자 연락처, 계약 내용, 내부 시스템 주소처럼 요약 결과에는 필요하지 않은 정보가 함께 들어 있기 때문이다.
나는 AI에게 보고서 초안이나 분류 작업을 맡길 때 원본을 통째로 전달하지 않는다. 먼저 작업에 꼭 필요한 내용만 골라 별도 사본을 만들고 식별 가능한 정보를 지운다. 무엇을 지웠는지 기억에만 의존하지 않도록 몇 가지 항목을 고정해서 확인한다.
이름을 가리는 것만으로 비식별화가 끝나지 않았다
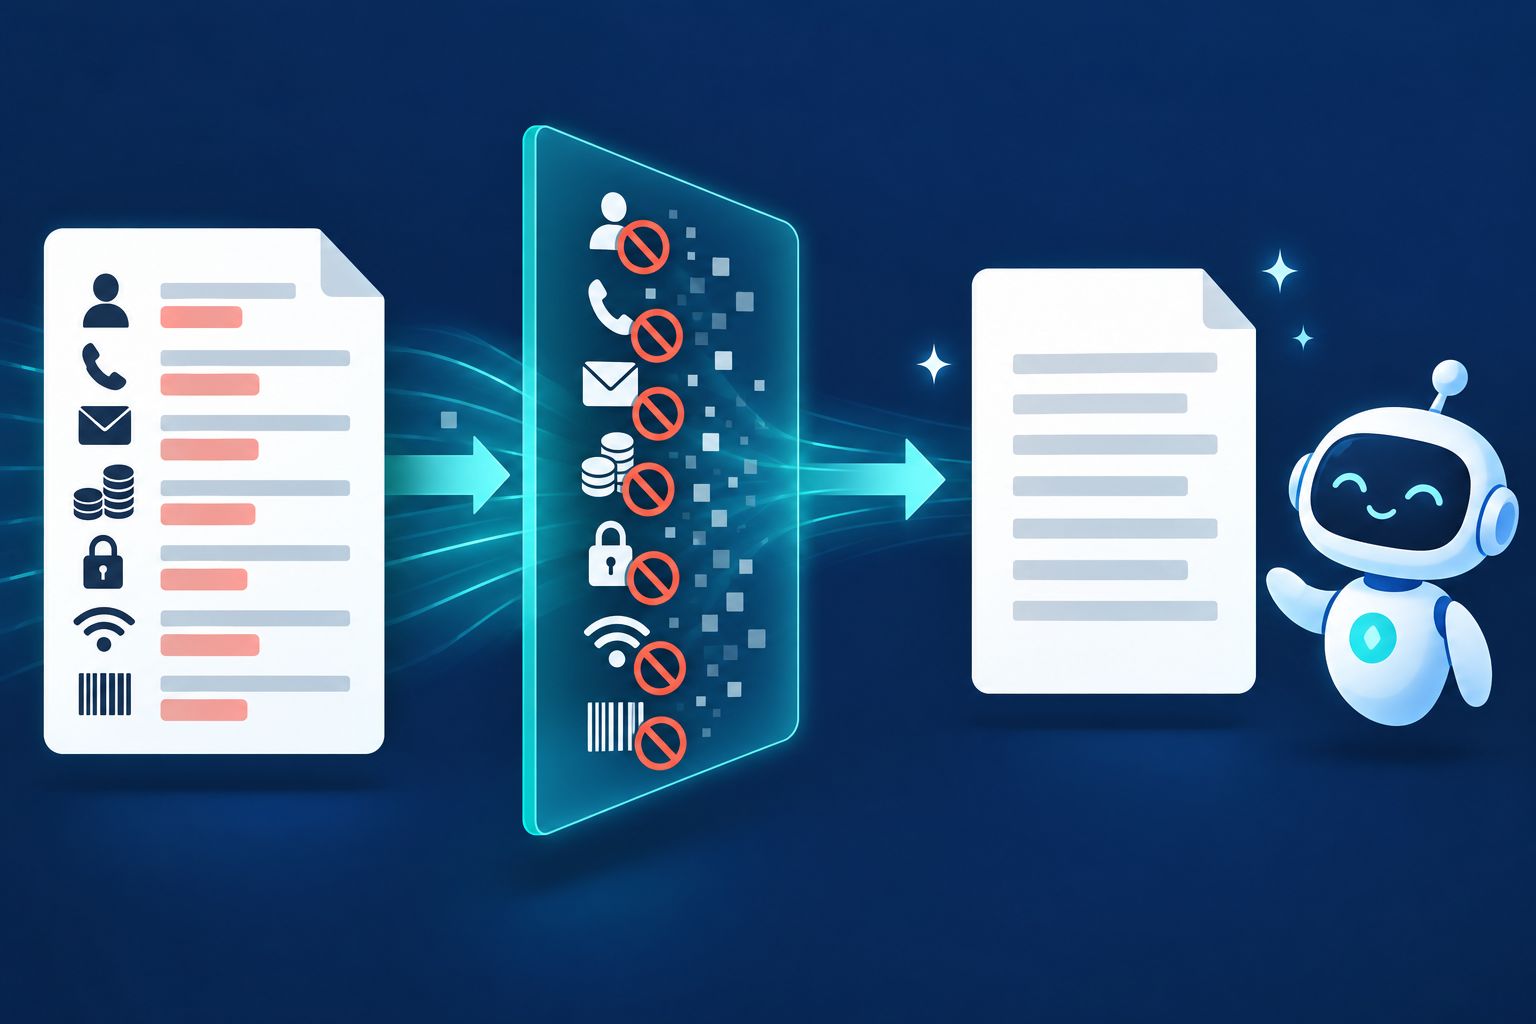
처음에는 사람 이름과 회사명만 다른 표현으로 바꾸면 된다고 생각하기 쉽다. 하지만 부서, 직책, 특정 날짜, 처리한 사건을 함께 적으면 이름이 없어도 누구인지 짐작할 수 있다. 나는 고객명은 고객 A처럼 바꾸고, 직원 이름과 사번, 전화번호, 이메일 주소는 삭제한다. 문맥상 꼭 필요한 직책도 범위를 넓혀 표현한다.
여러 정보가 합쳐졌을 때 식별되는지도 본다. 작은 조직에서 ‘특정 날짜에 특정 시스템을 담당한 사람’이라는 설명은 사실상 한 사람을 가리킬 수 있다. AI가 문장을 이해하는 데 필요하지 않은 세부정보라면 제거한다. 비식별화의 기준을 글자 몇 개를 가리는 작업이 아니라, 결과를 읽은 사람이 대상을 알아볼 수 있는지로 바꿨다.
계정, 내부 주소, 운영 수치는 별도 항목으로 확인한다
서버와 시스템 업무 기록에는 보안상 더 민감한 정보가 섞인다. 계정 ID, 비밀번호, 인증정보, IP 주소, 내부 URL, 데이터베이스 연결정보는 AI 입력 자료에서 제외한다. 화면을 캡처할 때도 장비 라벨과 바코드, 주소가 보이는지 확인한다. 단순한 장비 사진이라도 조직과 시스템을 식별할 단서가 될 수 있기 때문이다.
계약금액, 공개 전 실적, 상세 처리 건수 같은 운영 수치도 목적을 따져 본다. 보고서 문장 구조만 만들 때는 실제 금액 대신 금액 A, 실제 건수 대신 예시 범위를 사용할 수 있다. 정확한 숫자가 꼭 필요한 분석이라면 먼저 회사 정책과 허용된 도구인지 확인한다. 편의를 위해 입력 범위를 넓히기보다 결과에 필요한 최소 자료만 남긴다.
원본과 AI용 사본을 분리해 실수를 줄였다
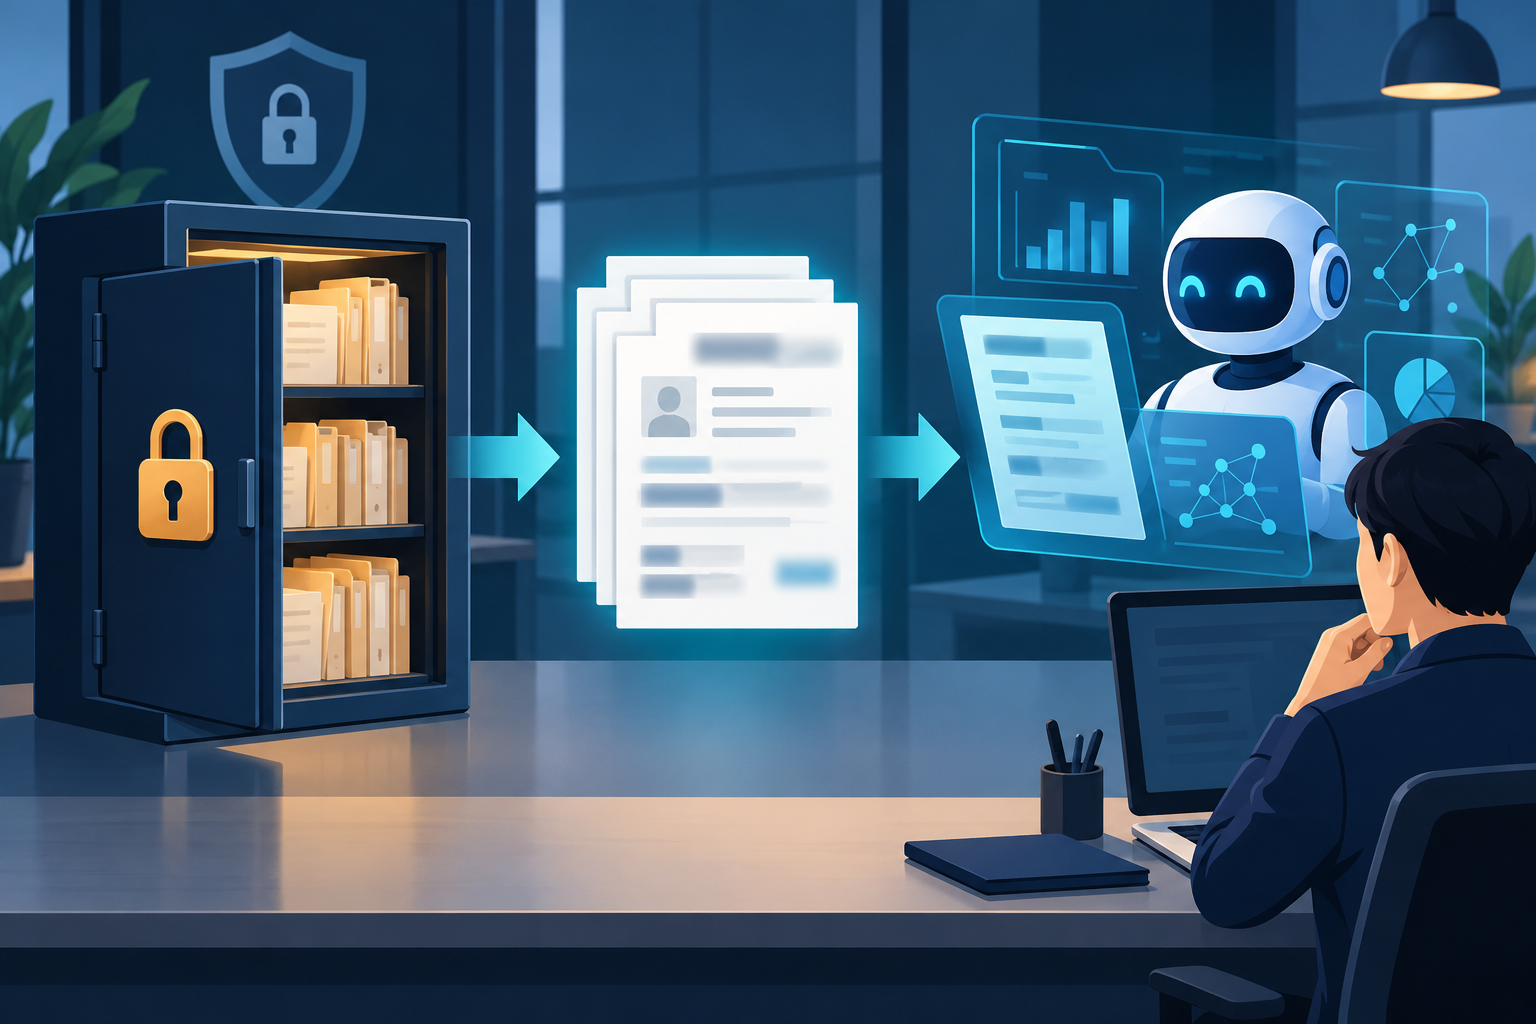
나는 원본 문서를 직접 수정해 정보를 지우지 않는다. 원본은 정해진 위치에 보존하고 AI 작업용 사본을 따로 만든다. 사본에는 날짜와 출처를 남기되 사람과 시스템을 식별할 값은 제거한다. 이렇게 해야 AI 결과를 검증할 때 원본을 다시 확인할 수 있고, 비식별화된 자료가 원본처럼 유통되는 일도 막을 수 있다.
입력 전에는 검색 기능으로 전화번호 형식, 이메일 기호, 내부 주소 형식, 계정 관련 단어가 남았는지 다시 확인한다. 이미지가 포함됐다면 본문만 보지 않고 이미지 안의 글자도 확인한다. 문서 제목과 파일명에 회사명이나 시스템명이 남는 경우도 있어 파일 내용과 함께 점검한다. 이 과정은 몇 분이 걸리지만 자료를 전송한 뒤 되돌리는 것보다 훨씬 짧다.
도구의 편리함보다 회사 기준을 먼저 적용한다
같은 AI 서비스라도 계정과 요금제에 따라 대화 저장, 학습 사용, 관리자의 보존 설정이 다를 수 있다. 나는 기능 소개만 보고 업무 자료를 넣지 않는다. 회사에서 승인한 도구와 입력 허용 범위를 먼저 확인하고, 외부 생성형 AI 사용이 금지된 자료는 입력하지 않는다. 필요하면 사내 승인 환경이나 외부로 전송되지 않는 방식만 검토한다.
비식별화를 시작한 뒤 AI 활용이 불편해진 것이 아니라 오히려 목적이 분명해졌다. 어떤 정보가 결과에 필요한지 먼저 생각하게 됐고, AI에는 최소한의 자료만 전달하게 됐다. 나는 앞으로도 문서를 빠르게 만드는 것보다 입력해도 되는 자료인지 확인하는 일을 먼저 할 것이다. AI 작업의 첫 단계는 프롬프트 작성이 아니라 자료를 줄이는 일이다.
'AI·IT 실무' 카테고리의 다른 글
| ChatGPT와 Claude Code에 어디까지 권한을 줘야 할까, 내가 정한 5단계 (0) | 2026.10.04 |
|---|---|
| AI 작업 완료와 업무 검증 완료가 다른 이유 (0) | 2026.10.03 |
| ChatGPT·Claude·Gemini를 다 쓰는 이유, 하나만 고르지 않은 업무 기준 (0) | 2026.10.02 |
| AI가 만든 SQL은 실행됐지만 결과는 틀렸다 (0) | 2026.10.02 |
| AI 서버 점검 자동화: 일주일 걸리던 Linux·Solaris 스크립트를 10분에 만든 과정 (0) | 2026.10.01 |