티스토리 뷰
NAS 용량이 100%까지 찼다. 더 저장할 공간이 없다는 것을 확인하고 나서야 내가 관리하던 백업 방식에 문제가 있다는 사실을 확인 했다. 그동안은 용량이 얼마나 빨리 증가하는지 기록하지 않았고, 언제 데이터를 옮겨야 하는지 정해진 기준도 없었다. 장애가 발생하면 그때 처리하는 방식이었다. NAS가 가득 찬 화면을 본 그날부터 나는 백업 절차를 만들어서 관리하기 시작했다.
1. NAS 백업 정책, 100% 차고 나서야 만들었다
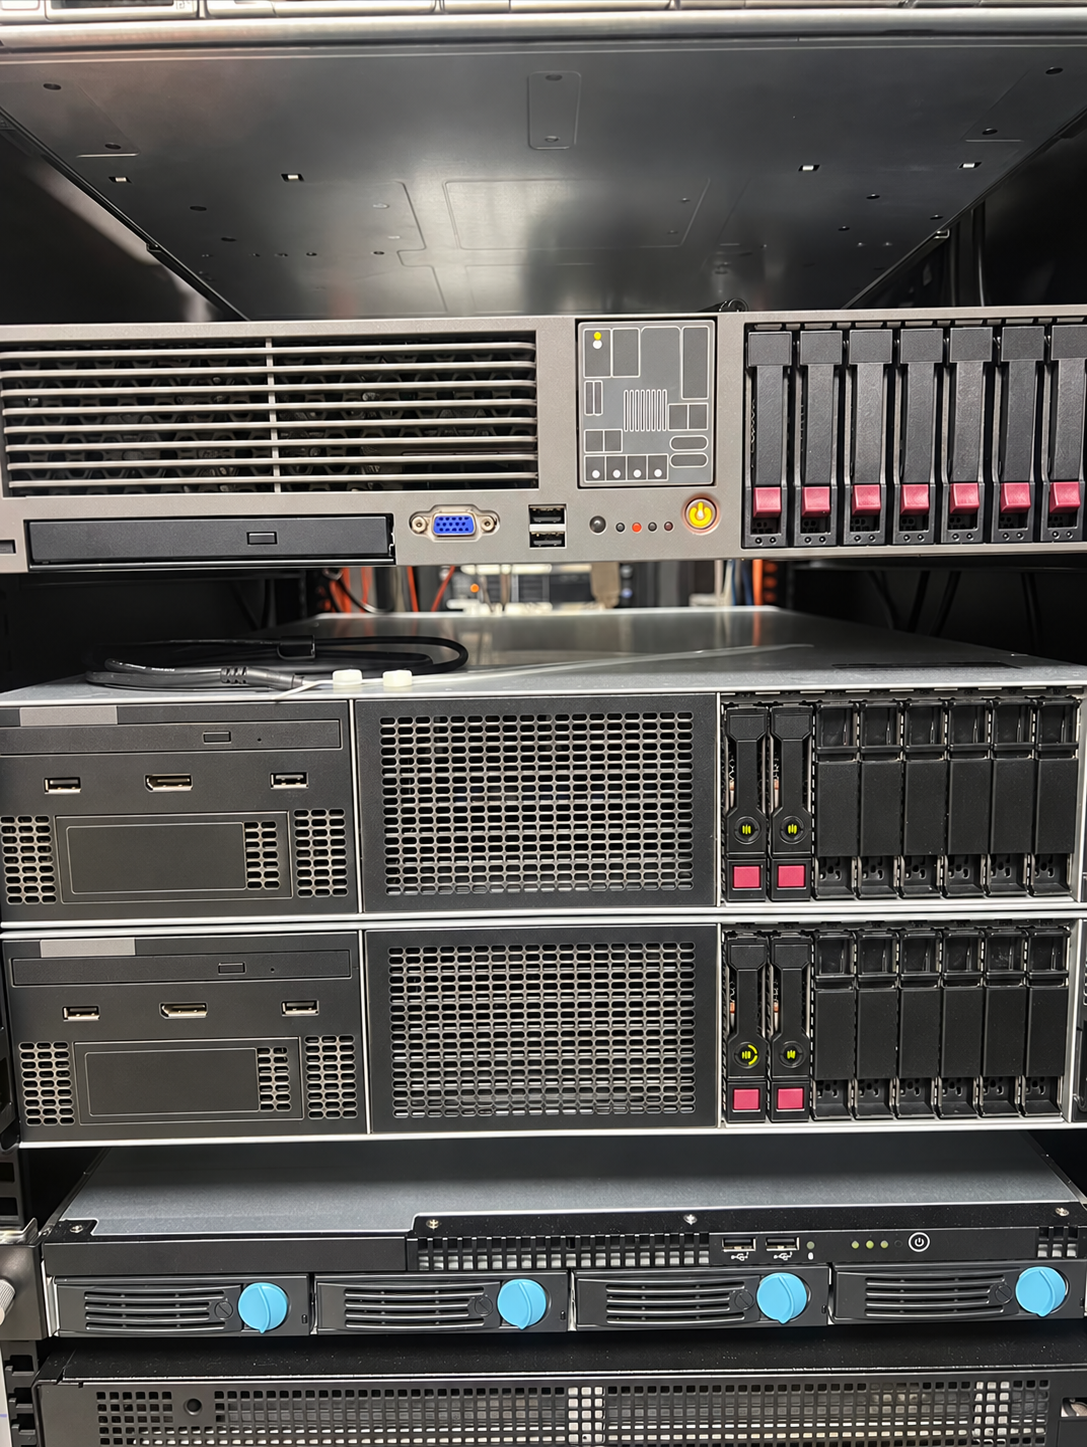
나는 NAS 용량이 100%까지 찬 뒤 저장 공간이 증가한 과정을 다시 확인했다. 확인해 보니 용량이 80~85% 구간을 15일 정도면 차는 것을 확인 했다. 이 기록을 보고 15일을 백업과 정리 주기로 잡았다. NAS의 데이터를 SFTP로 외장 저장장치에 이전하고, 이전이 끝난 것을 확인한 다음 NAS의 기존 데이터를 정리했다.
외장 저장장치를 밖으로 옮기는 일도 말로만 처리하지 않았다. 어떤 장비를 왜 반출하는지 기록하기 위해 반출장비 보고서를 작성했다. 누가 장비를 가지고 나갔고, 어디에 보관하며, 다시 확인해야 할 시점이 언제인지 남겼다. 내가 자리를 비우더라도 다른 사람이 보고 현재 상태를 알 수 있어야 했다. 처음에는 NAS 공간을 비우기 위해 시작한 일이었지만, 직접 해보니 데이터 이전과 장비 반출까지 하나의 절차로 묶어야 했다. 그래서 내가 실제로 처리한 순서를 기준으로 NAS 백업 정책과 절차서를 직접 만들었다.
2. 화재에 대비한 백업을 다른 건물 금고에 보관했다
나는 외장 저장장치에 데이터를 옮겼다고 해서 백업이 끝난 것은 아니라고 생각했다. NAS와 외장 저장장치를 같은 건물 안에 두면 화재나 재난이 발생했을 때 원본과 사본을 동시에 잃을 수 있었다. 그래서 외장 저장장치를 다른 건물의 금고에 보관했다. 공개 글에는 실제 보관 위치와 장비 식별정보를 적지 않지만, 내부 반출 보고서에는 필요한 관리 정보를 남겼다.
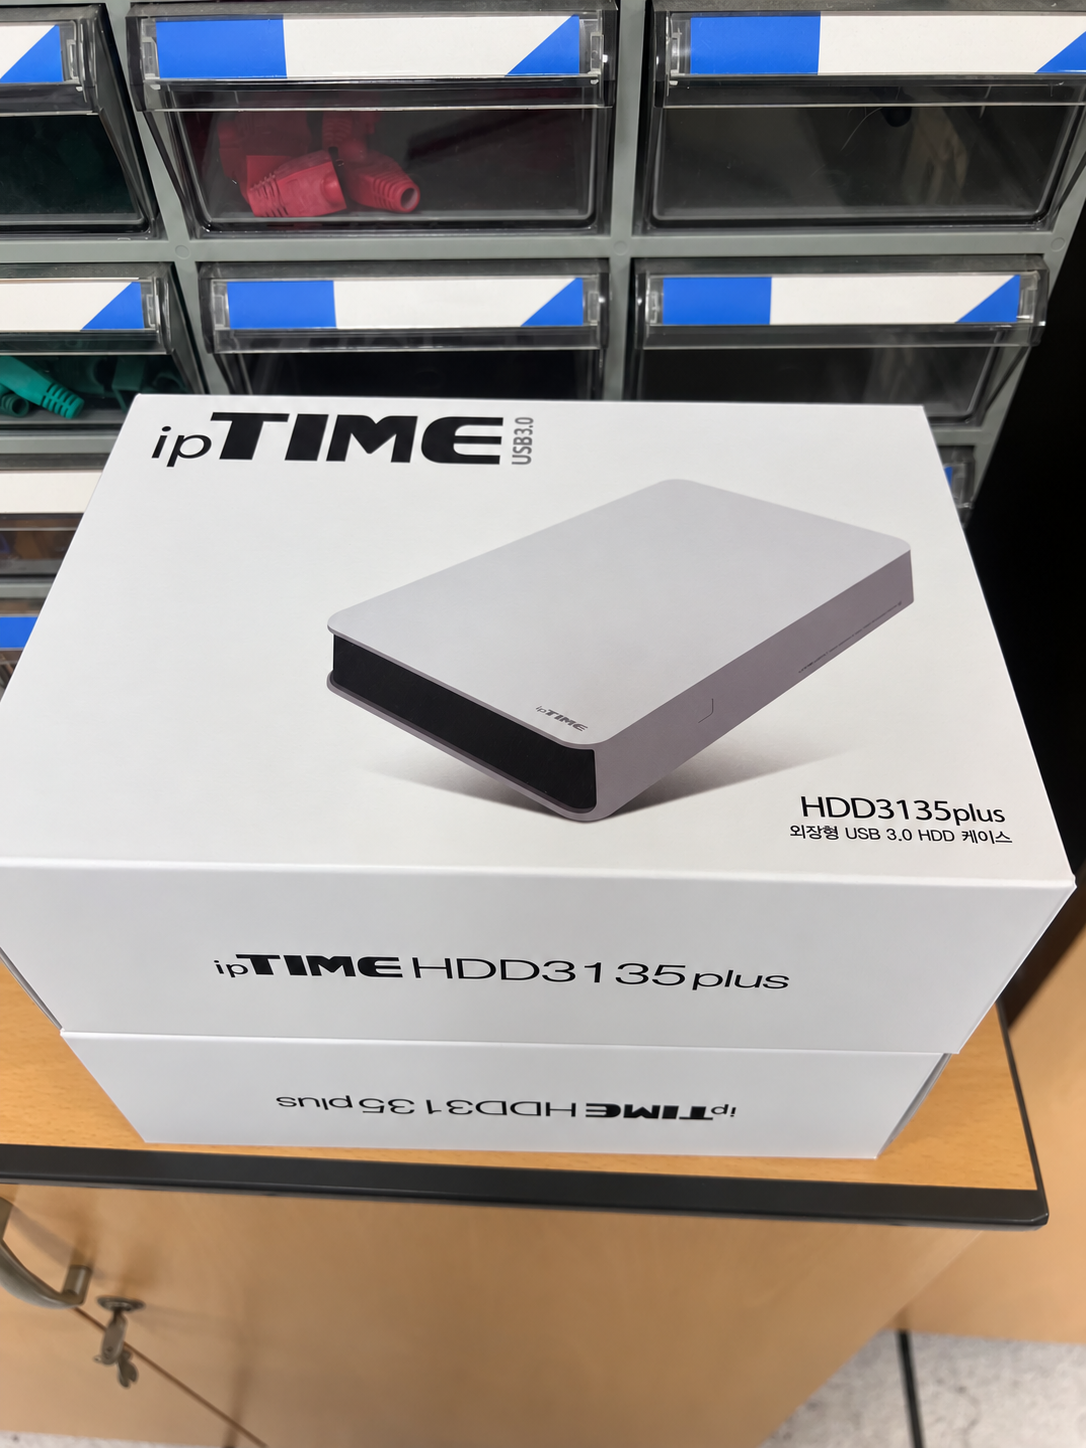
15일마다 데이터를 확인하고 외장 저장장치로 옮기는 일은 솔직히 불편했다. 장비를 연결하고 데이터를 이전한 뒤 결과를 확인하고, 반출장비 보고서를 작성해 다른 건물로 옮겨야 했다. 이 작업을 반복할 때마다 시간이 들었다. 그래도 NAS에만 데이터가 있던 때와 비교하면 마음은 훨씬 편해졌다. NAS에 문제가 생겨도 다른 장소에 사본이 있다는 사실이 주는 안정감이 있었다. 나는 편리하지 않다는 이유로 중단하지 않고, 먼저 수동 절차를 유지하면서 자동화할 수 있는 부분을 찾기 시작했다.
3. AI로 백업을 자동화하고 크론으로 매시간 서버를 점검했다
나는 반복하는 작업을 줄이기 위해 AI로 백업 스크립트와 서버 점검 스크립트를 작성했다. 크론을 이용해 매시간 서버 상태를 확인하고, 점검 결과를 메일로 받도록 구성했다. 이전에는 내가 서버에 접속해 상태를 하나씩 확인해야 했다. 자동화한 뒤에는 정해진 시간마다 점검이 실행됐고, 나는 결과 메일을 보고 이상 여부를 확인할 수 있었다.
스크립트를 바로 운영 서버에 넣지는 않았다. 먼저 로컬에서 실행하고, 그다음 테스트 서버에서 확인한 뒤 마지막으로 운영 서버에 적용했다. 로컬, 테스트 서버, 운영 서버의 3단계로 검증하고 크론에 반영하는 데 이번 작업은 약 20분이 걸렸다. AI를 사용하기 전에는 비슷한 스크립트 하나를 작성하고 오류를 수정하는 데 일주일 정도 걸린 적도 있었다. 모든 작업이 항상 20분 안에 끝난다는 뜻은 아니다. 내가 이미 알고 있던 업무 절차를 AI에 설명하고, 만들어진 스크립트를 단계별로 검증한 이번 사례가 20분 정도 걸렸다는 뜻이다.
주변에서는 내가 만든 자동화를 보고 프로그램을 만들었다고 말했다. 하지만 내가 한 일은 새로운 서비스를 개발한 것이 아니라, 내가 매번 손으로 하던 점검 순서를 스크립트로 옮긴 것이었다. AI가 내 업무를 대신 판단한 것도 아니다. 무엇을 점검할지, 어떤 결과를 확인할지, 어느 단계에서 운영 서버에 반영할지는 내가 결정했다.
4. 서버 암호 변경 기록이 없어 서비스가 하루 동안 중단됐다
서버 암호 변경 기록이 제대로 남아 있지 않아 서비스가 하루 동안 중단된 적도 있었다. 당시에는 정확한 원인을 바로 밝히지 못했고, 우선 ‘서버 오류’라고 보고했다. 문제를 해결하는 과정도 내가 혼자 맡았다. 결국 원인을 찾아 서비스를 복구했지만, 복구하고 나서 더 크게 남은 문제는 서버 계정과 암호에 관한 기록이 없다는 사실이었다. 담당자인 나만 알고 있는 정보가 많았고, 내가 없으면 다른 사람이 바로 대응하기 어려운 구조였다.
나는 이 일을 겪은 뒤 서버 암호 관리대장을 직접 만들었다. 대장에는 자산명, 운영체제, 계정 ID, 암호 관리 항목, 관리담당자와 부관리담당자를 구분해 기록했다. 문서는 시건장치가 있는 캐비닛에 보관했다. 한 사람만 내용을 알고 있는 구조가 위험하다고 판단해 관리담당자와 부관리담당자가 함께 확인하는 방식으로 바꿨다.
당시에 내가 선택한 방법은 종이 대장을 잠긴 장소에 보관하는 것이었다. 그러나 공개 글에는 실제 계정 ID, 암호, 서버 주소와 보관 위치를 적지 않는다. 암호 자체를 일반 관리대장에 그대로 남기는 방식도 계속 보완해야 할 부분이다. 지금은 누가 관리하고 있는지, 언제 변경했는지, 비상시에 누가 확인할 수 있는지를 남기는 구조가 더 중요하다고 생각한다.
5. 자동화로 생긴 시간을 내부 문서 작성에 사용했다
서버 점검을 자동화한 뒤 나는 남은 시간을 내부 보고용 문서를 작성하는 데 사용했다. 내가 매월 작성하는 문서에는 사이버안전진단의 날 점검보고, 접속기록 점검보고와 서버점검보고가 있다. 연 1회 작성하는 내부관리계획서와 개인정보처리방침도 있다. 이 문서들은 아직 자동화하지 못했고, 내가 직접 내용을 확인하면서 작성하고 있다.
자동화로 시간을 줄였지만 내 업무에서 더 큰 문제는 따로 있었다. 장애가 발생했을 때 어떤 순서로 확인하고 누구에게 보고해야 하는지 정리된 장애 대응 매뉴얼이 이 회사에는 없었다. 서버를 운영하면서 20년 동안 쌓은 경험과 판단 기준이 대부분 내 머릿속에만 있었다. 문제가 생기면 나는 무엇부터 확인해야 하는지 알고 있었지만, 다른 담당자는 내가 했던 과정을 처음부터 다시 찾아야 했다.
나는 이제 자동화 스크립트를 하나 더 만드는 것보다 머릿속에 있는 장애 대응 순서와 판단 기준을 문서로 옮기는 일이 먼저라고 판단했다. 그래서 지금 내가 실제로 처리했던 장애와 조치 방법을 하나씩 꺼내 업무인계서에 적고 있다. 다음 담당자가 내 자리에 앉았을 때 전화로 나를 찾지 않고도 첫 번째 조치를 시작할 수 있게 만드는 것이 지금 내가 하려는 다음 작업이다.
'AI·IT 실무' 카테고리의 다른 글
| AI가 만든 SQL은 실행됐지만 결과는 틀렸다 (0) | 2026.10.02 |
|---|---|
| AI 서버 점검 자동화: 일주일 걸리던 Linux·Solaris 스크립트를 10분에 만든 과정 (0) | 2026.10.01 |
| 옵시디언으로 업무 노트 정리하는 법: 폴더 구조와 일일 노트 설정 (0) | 2026.09.16 |
| 장애 보고서 작성법: 1보·중간·최종 보고에 무엇을 써야 할까 (0) | 2026.09.16 |
| ChatGPT 기획 대화가 열리지 않아 작업 기록을 잃었습니다: 그 뒤로 Git과 옵시디언에 단계별로 남깁니다 (0) | 2026.09.16 |